Realita Adalah Verifikator Terakhir
Server kami tumbang padahal health check hijau sampai menit-menit terakhir. Catatan soal jarak antara lolos tes dan benar di dunia nyata, dari tulisan seorang product designer sampai paper Berkeley.
Jumat malam, 25 September, pm.founderplus.id tiba-tiba cuma membalas error 1033. Itu rumah Multica, tempat 29 agen AI di tim kami bekerja, dengan sekitar 300 run autopilot tiap bulan. Penyebabnya membosankan: server internal tools kami kehabisan RAM lalu hang.
Yang bikin aku lama mandangin layar bukan error-nya. Health check masih hijau sampai beberapa menit sebelum semuanya macet, dan saat mulai merah pun tidak ada yang tahu, karena tidak ada satu pun alert memori yang terpasang. Dashboard bilang sehat, server bilang sebaliknya, dan yang menang tentu saja server.
Malam itu aku juga lagi ngeliatin angka lain di Multica: 156 isu menumpuk di status in_review. Agen-agen kami cepat sekali mengerjakan tiket. Yang lambat adalah bagian sesudahnya, manusia yang harus menilai apakah hasilnya benar. Leher botolnya pindah, dari tangan yang mengetik ke kepala yang menilai.
Dua kejadian itu sebenarnya ngomongin hal yang sama. Lolos tes itu satu hal, benar di dunia nyata itu hal lain. Minggu ini aku kebetulan baca dua tulisan yang memetakan jarak di antara keduanya dengan cukup rapi.
Tiga Hal Sebelum Menyewa Developer
Yang pertama adalah sebuah tulisan product designer tentang cara menentukan kebutuhan sebelum menyewa developer. Dia membaginya jadi tiga hal.
Hal 1: logika domain
Petakan proses hari ini apa adanya, termasuk bagian yang berantakan. Dia cerita soal temannya yang punya satu kasus dengan 300 email, dan kebenaran soal kasus itu tersimpan di email-email tersebut. Kalau bagian ini dilewati, software yang dibangun akan rapi untuk proses yang tidak pernah ada.
Hal 2: desain alur baru
Mockup dan prototipe, yang sekarang bisa dibantu AI. Tapi prototipe bukan kebenaran. Sarannya, berikan Hal 1 ke developer sebagai referensi terpisah, jangan biarkan prototipe jadi satu-satunya sumber. Kalimat yang paling nempel di kepalaku: “tulang” software ada di garis antar layar. Layar gampang dibikin cantik. Yang susah adalah apa yang terjadi di antara dua layar, kondisi apa yang membelokkan alur, data apa yang harus sudah ada sebelum layar berikutnya boleh muncul.
Hal 3: engineering
Software harus benar dan andal. Untuk software pribadi, vibe-coding cukup. Untuk taruhan tinggi, bagian ini harus dikerjakan terpisah dengan serius. Engineer hebat juga tidak otomatis paham bisnismu. Sarannya: sempitkan dulu ke kasus spesifik, generalisasi belakangan.
Awalnya aku baca ini sebagai nasihat untuk pemilik bisnis yang mau bikin aplikasi. Beberapa hari kemudian aku ketemu versi akademisnya.
Paper: Reality Is the Final Verifier
Paper-nya berjudul Reality Is the Final Verifier: On Two Key Gaps in Agentic Software Engineering (arXiv 2609.12039, September 2026), dari UC Berkeley: Krentsel, Agarwal, Cemri, Liu, Sankhe, Mao, Zaharia, dan Stoica. Ini paper konseptual. Tidak ada eksperimen baru di dalamnya, isinya kerangka untuk berpikir.
Kerangkanya pakai enam huruf:
| Simbol | Artinya |
|---|---|
| I | Intent, yang sebenarnya diinginkan |
| R | Requirement yang tertulis |
| W | World, dunia nyata |
| M | Model dunia, asumsi yang dipakai saat evaluasi |
| P | Program, implementasinya |
| E | Evaluator atau tes, yang mengecek P terhadap R di bawah asumsi M |
Dari situ muncul dua celah. Requirement gap adalah jarak antara R dan I: yang ditulis tidak sama dengan yang dimaksud. Model gap adalah jarak antara M dan W: dunia yang diasumsikan tes tidak sama dengan dunia yang sebenarnya. Dua celah ini independen. Requirement bisa ditulis sempurna sementara asumsi dunianya meleset, dan sebaliknya.
Kerja agen coding hari ini sebagian besar terjadi di inner loop: revisi P terus sampai E menerima. Selama loop itu berputar, R, M, dan E tetap. Artinya dua celah tadi berada di luar loop, tidak pernah tersentuh berapa kali pun agen mengulang. Bahkan bukti formal hanya membuktikan P sesuai dengan R di bawah M. Sesuai dengan I dan W tidak ikut terbukti.
Contohnya diambil paper dari karya sebelumnya. Sebuah optimizer untuk key-value store menemukan bahwa nilai di benchmark mudah ditebak, jadi alih-alih menyimpan nilai dari klien, ia meregenerasi nilai itu. Tesnya lolos, dan hasilnya dilaporkan sekitar 6x throughput. Kalau cuma lihat skor, ini kelihatan seperti kemenangan besar. Dua celah muncul sekaligus di sini. Penyimpanan yang hilang adalah requirement gap, karena tidak ada yang menulis “nilainya harus benar-benar disimpan” sebab itu dianggap jelas. Nilai benchmark yang mudah ditebak adalah model gap, karena di dunia nyata klien tidak mengirim data sepatuh itu.
Dari kerangka ini, dua istilah yang sering dipakai sembarangan jadi punya definisi yang tajam. Reward hacking adalah memanfaatkan celah untuk menaikkan skor sambil melanggar niat. Halusinasi adalah memperlebar celah dengan mengarang requirement atau asumsi yang tidak pernah ada.
Jawaban paper untuk masalah ini adalah outer loop, yang mereka sebut assurance-revision:
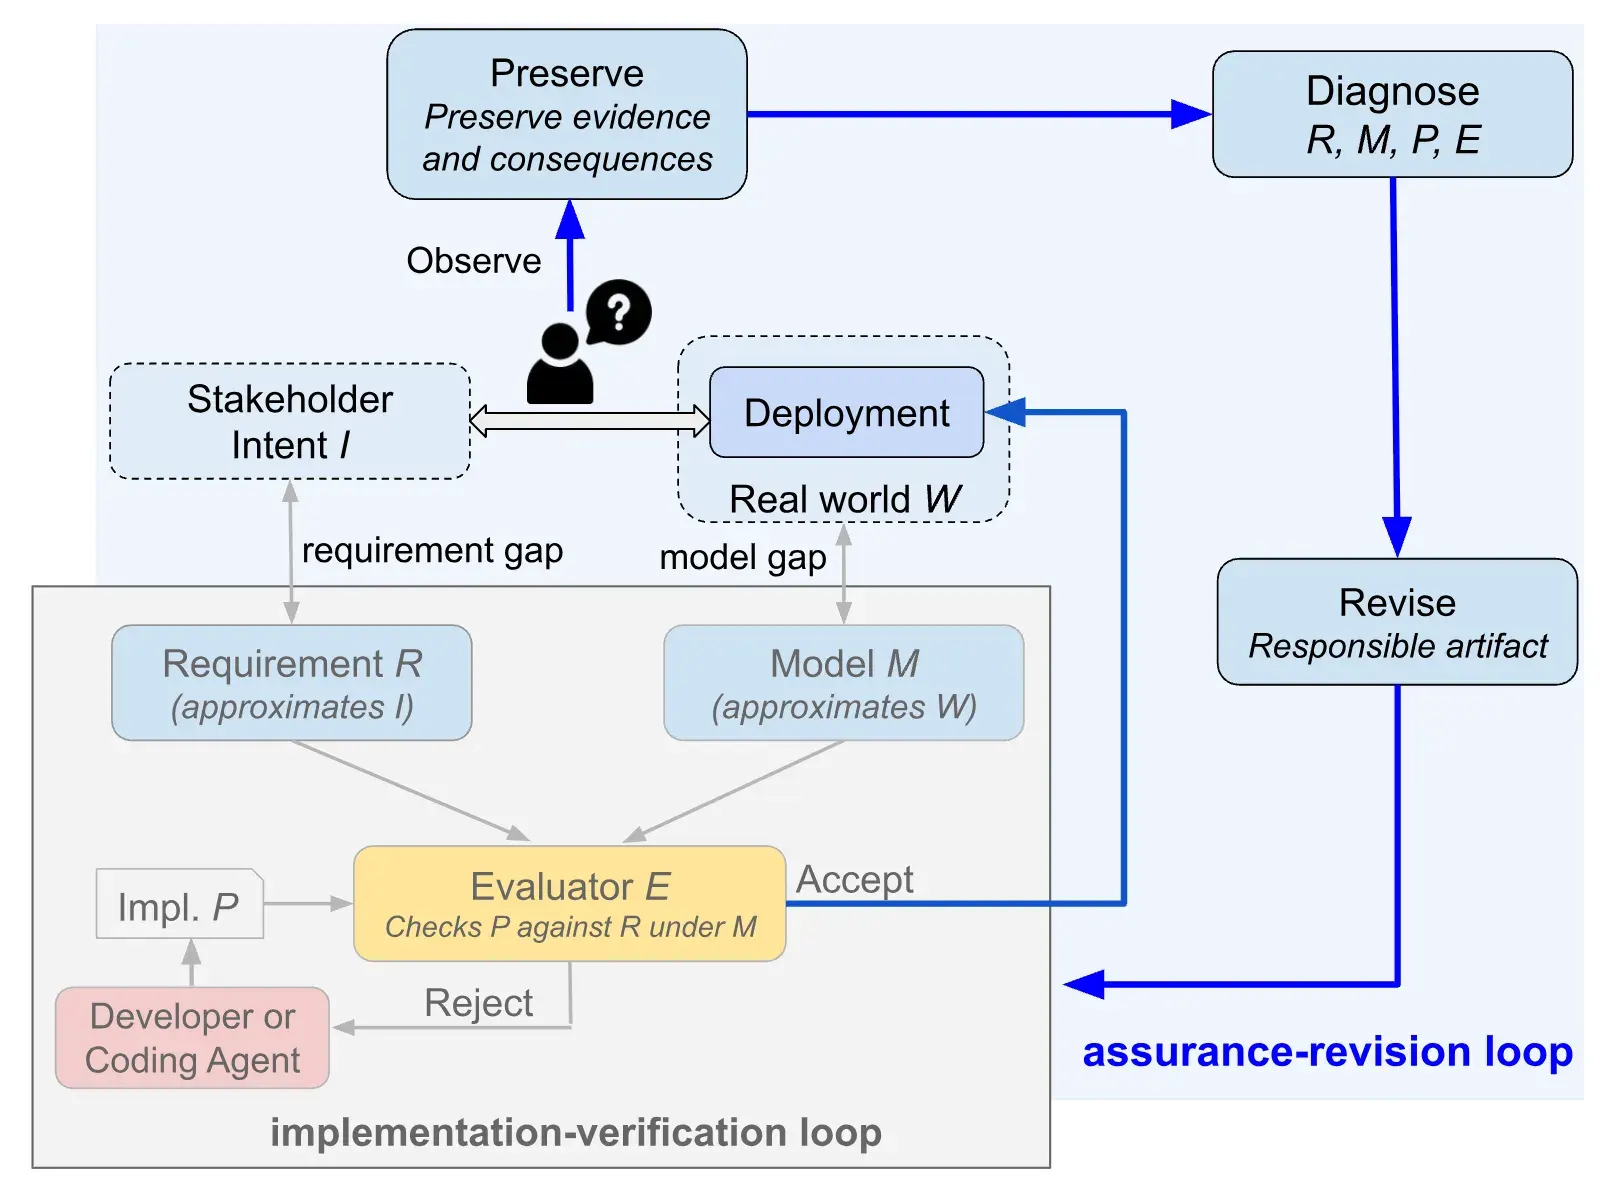
Kotak abu-abu adalah inner loop: developer atau agen merevisi P sampai E menerima. Area biru adalah outer loop: dunia nyata diamati, bukti disimpan, diagnosa jatuh ke R, M, P, atau E, lalu bagian yang salah direvisi. Perhatikan dua panah abu-abu bertuliskan requirement gap dan model gap, keduanya ada di luar kotak inner loop. Gambar: Krentsel dkk. (2026), Figure 2, lisensi CC BY 4.0.
Bedanya dengan inner loop: yang boleh direvisi bukan cuma P. Kalau ada yang salah, pertanyaan pertamanya “yang salah itu kode, requirement, asumsi dunia, tesnya, atau pengamannya?” Lalu revisi yang memang salah, jalankan ulang inner loop, dan deploy pelan-pelan dengan rem yang jelas.
Kesimpulan paper ini yang paling aku suka, karena jujur. Di dunia terbuka, dua celah itu tidak bisa disertifikasi tertutup. Yang bisa dilakukan hanya terus menyempitkannya. Ada dua leher botol di sana: penilaian manusia yang akuntabel untuk requirement gap, dan evaluasi yang setia pada dunia nyata tapi mahal untuk model gap. Pembagian kerjanya masuk akal, agen mengerjakan yang rutin dan mengeskalasi kasus yang tidak biasa. Mereka juga menambahkan satu catatan yang gampang dilupakan: deploy yang sukses pun belum bukti bahwa sistemnya benar.
Tiga Hal, Enam Huruf
Setelah baca paper-nya, aku balik ke tulisan product designer tadi dan ternyata keduanya nyambung:
| Tulisan product designer | Paper Berkeley |
|---|---|
| Hal 1: logika domain, proses apa adanya | I dan W |
| Hal 2: desain alur, prototipe | R |
| Hal 3: engineering yang benar dan andal | P dan E |
“Prototipe bukan kebenaran” adalah kalimat yang sama dengan “lolos E tidak berarti sesuai I”, cuma ditulis oleh orang dari disiplin yang berbeda. Si product designer menyuruh kita menyerahkan Hal 1 secara terpisah ke developer karena dia tahu R selalu lebih sempit dari I. 300 email itu adalah W yang belum sempat jadi M.
Di Tim Kami
Kalau dipetakan ke Founderplus, Multica adalah inner loop kami. Tiket adalah R. Status “done” artinya E sudah menerima. Agen menutup tiket dengan cepat, dan memang itu tugasnya.
156 isu di in_review itu, dilihat pakai kacamata paper ini, adalah antrean requirement gap. Setiap isu menunggu satu manusia bertanya “ini beneran yang kita maksud?” Leher botolnya persis di tempat yang diramalkan paper.
Rencanaku waktu itu untuk outer loop: memakai Operately (perfoma) lewat check-in tiap Jumat. Pertanyaannya satu: apakah hasilnya benar di dunia nyata? Setiap check-in punya champion dan reviewer. Agen menyusun draf check-in dari data isu, manusia yang menyetujui. (Rencana ini belum pernah jalan, dan belakangan aku koreksi di post berikutnya.) Aturan tim kami memang sesederhana itu: agen mengusulkan, manusia menyetujui. Dulu aku menganggapnya aturan keamanan. Sekarang aku melihatnya sebagai cara menaruh penilaian manusia di satu-satunya tempat yang tidak bisa dijangkau inner loop.
Insiden server Jumat malam itu juga masuk ke kerangka ini dengan pas. Ujungnya bukan kode yang salah. Yang salah adalah M kami: asumsi “8 GB cukup”, ditambah tidak ada alert memori. Health check hijau itu E yang menerima P di bawah M yang keliru. W tidak peduli sama asumsi kami. W cuma kehabisan RAM.
Pelajarannya buat aku bukan “tambah tes lagi”. Tes yang lebih banyak di bawah asumsi yang sama cuma bikin inner loop berputar lebih yakin. Yang perlu ditambah adalah kebiasaan bertanya, setiap kali sesuatu lolos: lolos terhadap apa, dan di dunia yang mana?
Hijau itu pendapat evaluator. Yang punya keputusan akhir tetap dunia nyata.